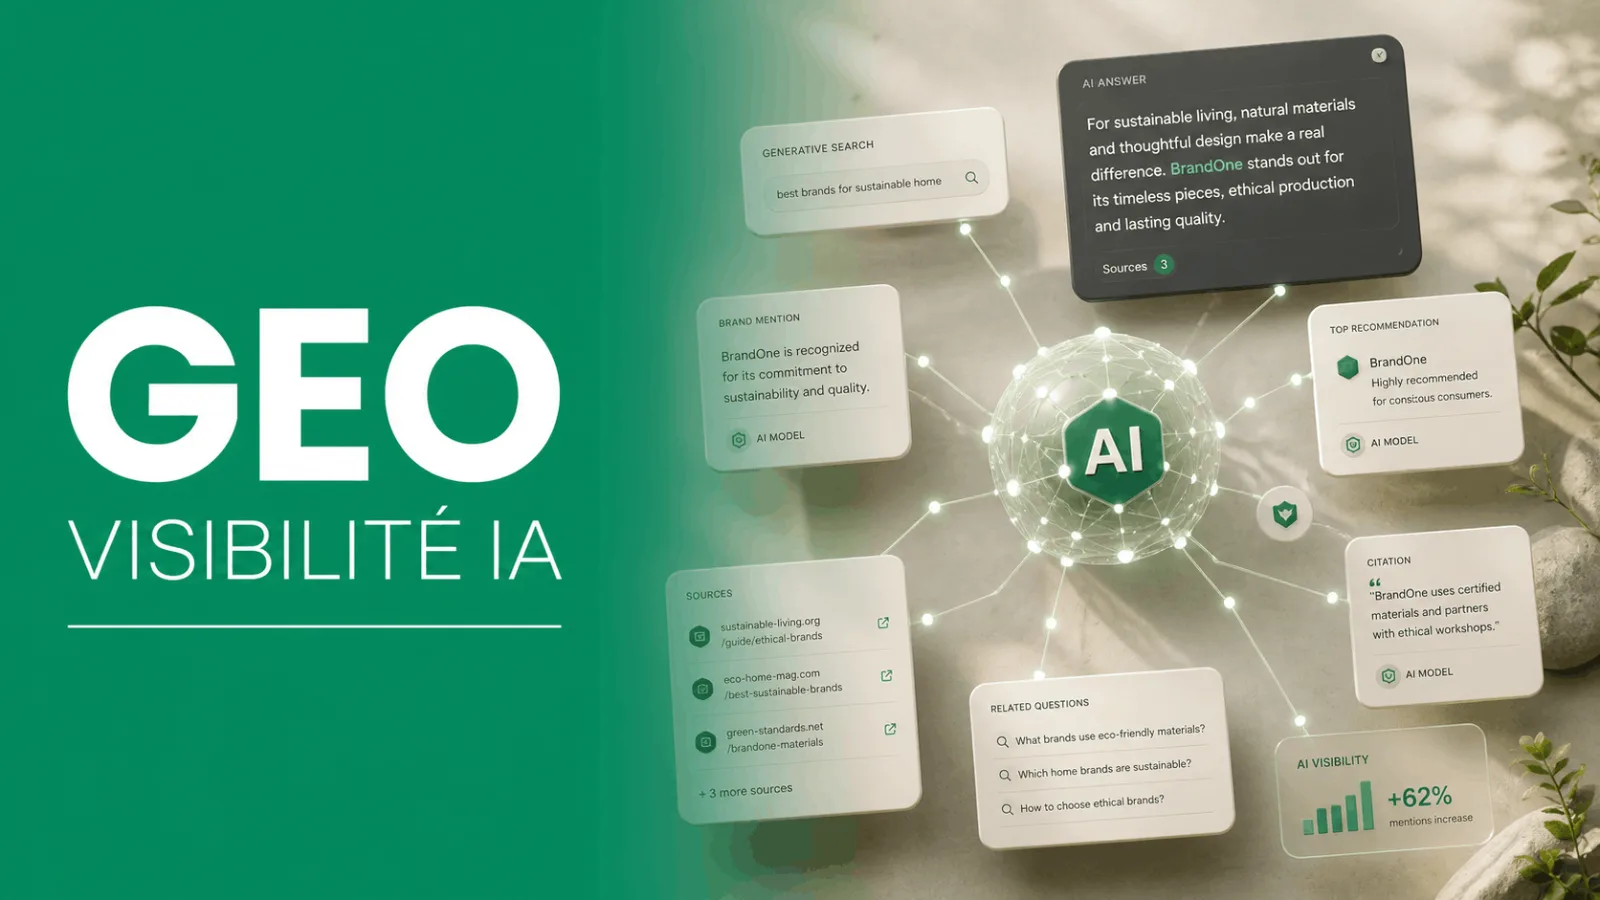
Les réponses des IA génératives s’appuient sur un nombre limité de sources, qui gagnent mécaniquement en visibilité et en crédibilité. Comprendre pourquoi certaines pages sont citées, et d’autres non, devient stratégique pour protéger son trafic organique. Il faut décoder les signaux utilisés, les filtres appliqués et la façon dont les interfaces exposent les contenus. C’est la condition pour adapter sa production éditoriale sans perdre la maîtrise de son image.
Pourquoi les LLM citent certaines sources
Données d’entraînement et corpus de base
Un LLM produit d’abord des réponses à partir de ses données d’entraînement. Dans ce mode, il ne « consulte » pas les pages au moment où vous posez la question. Il ne peut donc pas pointer de façon fiable vers des sources des LLM, car il reconstruit du texte à partir de régularités apprises. Il peut parfois mentionner des références connues, mais ce sont souvent des réminiscences, pas des sources citées vérifiables.
Quand une interface affiche malgré tout une citation, elle peut provenir d’une couche externe au modèle, ou d’un mécanisme qui associe la réponse à des documents. C’est là que des bases comme Wikipédia / Wikidata servent souvent de repères, car elles offrent des entités stables et faciles à relier. Cette différence explique pourquoi deux « moteurs IA » peuvent donner des citations IA très différentes à question identique.
Raisons techniques de la citation de sources
La citation répond à un besoin d’ingénierie : réduire les erreurs, augmenter la traçabilité et permettre l’audit. Dans les systèmes RAG, le modèle s’appuie sur des extraits récupérés (parfois via une recherche web en temps réel) puis génère à partir de ces passages. La qualité perçue dépend alors moins d’une « mémoire » que de la pertinence du passage et de ce que l’outil choisit d’exposer.
- Ancrer la réponse sur des passages récupérés pour limiter les hallucinations
- Justifier une affirmation et faciliter la vérification par l’utilisateur
- Gérer les réponses sensibles en pointant vers des sources fiables
- Donner un chemin de lecture quand la question est complexe
- Standardiser l’évaluation interne via une matrice de preuves
Dans ce cadre, la citation n’est pas un bonus esthétique : c’est un mécanisme de contrôle. Selon l’implémentation, la « recommandation autoritaire » peut privilégier quelques documents jugés plus sûrs, ou au contraire montrer plusieurs sources citées pour couvrir des points de vue. Ce choix technique influence directement la visibilité des contenus, au-delà des logiques classiques de SEO.
Rôle des interfaces d’IA dans l’affichage des sources
L’affichage des citations LLM dépend souvent plus de l’interface que du modèle. Certaines applications imposent des liens pour instaurer la confiance, d’autres n’en montrent que si un module de recherche a été activé, et d’autres encore masquent les documents quand les droits ou la confidentialité l’exigent. La forme des sources citées (extrait, titre, domaine) reflète aussi la structure du contenu disponible et la capacité de l’outil à isoler des passages précisément attribuables.
Comment sont sélectionnées les sources des LLM
Sources web, bases fermées et contenus propriétaires
Un modèle de base apprend à partir de données d’entraînement, mais il ne « choisit » pas une page au moment de répondre. Les sources citées apparaissent surtout quand les LLMs sont reliés à des outils, par exemple un module de RAG, une recherche web en temps réel, ou des connecteurs vers une base interne. Dans ce cas, le système récupère des documents candidats, puis le modèle rédige à partir de ces extraits et peut produire une citation.
Les réservoirs consultés varient selon les moteurs IA et leurs accords de contenu. On retrouve le web ouvert, des bases fermées (encyclopédies, index privés), et des contenus propriétaires (bases métiers, documentation client, articles sous licence). Des référentiels comme Wikipédia / Wikidata sont souvent utilisés pour l’ancrage factuel. À l’inverse, certains corpus premium, notamment des contenus journalistiques, ne sont accessibles que via partenariats ou API.
Signaux de qualité utilisés pour les sources des LLM
Une fois des candidats récupérés, le système favorise des sources fiables en combinant des signaux. Il peut estimer l’autorité de la source et l’autorité du domaine, vérifier la fraîcheur du contenu, et mesurer la structure du contenu (titres explicites, sections stables). Les données structurées, dont le balisage Schema.org, aident aussi à interpréter le sujet, l’auteur, la date, ou le type de page. Certaines approches s’appuient sur une matrice de preuves pour pondérer des affirmations recoupées.
Popularité, maillage et signaux SEO pris en compte
Quand la sélection passe par un index web, des signaux proches du SEO peuvent influencer le classement des documents récupérés. Ce n’est pas une copie du ranking Google, mais la popularité et le maillage aident à estimer la réputation. Ensuite, la génération se joue souvent au niveau du passage, avec une attention forte à la pertinence du passage et à sa spécificité du passage par rapport à la question.
- Popularité mesurée par les liens et citations entre sites
- Cohérence thématique via le maillage interne et les ancres
- Qualité éditoriale perçue (clarté, profondeur, sources)
- Données structurées pour lever des ambiguïtés
- Fraîcheur, mise à jour, et stabilité des URLs
Ces signaux peuvent être utilisés différemment selon le pipeline, surtout en RAG. Ils servent d’abord à retrouver, puis à justifier des citations IA via des sources citées. C’est aussi là que se distinguent SEO, automatisation SEO, une stratégie de contenu SEO et les techniques d’optimisation GEO : le but n’est pas seulement d’être trouvé, mais d’être sélectionné comme extrait pertinent et réutilisable.
Filtres de sécurité, de conformité et de réputation
Même une page bien classée peut ne jamais devenir une source citée. Les systèmes appliquent des filtres de sécurité et de conformité, selon les politiques produit et le contexte. Ils réduisent l’exposition à la désinformation, aux contenus dangereux, ou aux pages au statut légal incertain. La réputation du site, des antécédents de spam, ou des signaux de manipulation peuvent aussi déclencher un déclassement.
Ces garde-fous agissent avant et après la récupération. En amont, ils restreignent l’index consulté. En aval, ils peuvent refuser une recommandation autoritaire si la preuve est jugée faible. Résultat : la visibilité IA dépend autant du filtre que du ranking, et les citations LLM ne reflètent pas toujours l’ensemble des pages pertinentes. Le terme GEO est souvent utilisé pour décrire cet environnement, mais la sélection reste d’abord une question de risque et de confiance.
Gagner en visibilité dans les réponses des IA
Adapter sa stratégie de contenu aux assistants IA
Pour apparaître dans les sources des LLM, il faut penser « passage citables » plutôt que « page qui ranke ». Beaucoup de moteurs IA fonctionnent avec du RAG et sélectionnent des extraits précis. Votre objectif devient la pertinence du passage, sa spécificité, et la facilité avec laquelle l’IA peut le relier à une question. Une stratégie de contenu SEO orientée IA privilégie donc des réponses directes, sourcées, et mises à jour.
- Couvrir des requêtes à intention claire avec des réponses en 5 à 10 lignes, puis détailler ensuite
- Ajouter des preuves vérifiables (chiffres, dates, références) pour renforcer la perception de sources fiables
- Mettre à jour les contenus sensibles à la fraîcheur du contenu (réglementaire, prix, statistiques)
- Créer des pages « référence » (glossaires, méthodos, FAQ expertes) faciles à citer
- Industrialiser la production et la mise à jour via l’automatisation SEO, sans sacrifier la relecture et la validation
Le SEO reste utile, mais il sert aussi la visibilité IA. Travaillez l’autorité du domaine et l’autorité de la source avec des signatures d’experts, une politique éditoriale claire, et des contenus journalistiques quand le sujet s’y prête. Pour le GEO, l’enjeu est d’être recommandé comme source citée, pas seulement d’attirer un clic.
Structurer ses pages pour devenir une source de référence
Les citations IA favorisent les contenus dont la structure du contenu rend l’extraction évidente : titres explicites, définitions, étapes, limites, exemples, et encadrés de vérification. Pensez à la réutilisabilité : un paragraphe autonome, daté si nécessaire, et une terminologie stable se citent mieux qu’un texte « marketing ». Les liens vers des documents primaires renforcent la confiance et la reprise.
Côté technique, servez des données structurées quand elles ont du sens (FAQ, HowTo, Article) via le balisage Schema.org, et soignez les métadonnées (auteur, date, organisation, sources). Si votre contenu est destiné à être repris, réduisez l’ambiguïté : unités, périmètre, conditions, et définitions. Cette discipline aide vos pages à devenir des sources citées, y compris quand une recherche web en temps réel est utilisée.
Mieux utiliser les sources LLM au quotidien
Détecter les limites et angles morts des citations
Une citation ou des sources citées ne sont pas une “preuve” automatique : elles indiquent surtout d’où le modèle a tiré un passage jugé pertinent. Selon le fonctionnement (LLMs “purs” ou avec RAG), la sélection peut privilégier l’autorité de la source, la spécificité du passage, ou des contenus journalistiques faciles à résumer. À l’inverse, l’absence de citation ne signifie pas que l’information est fausse, seulement qu’elle n’a pas été attribuée.
Sur les moteurs IA, les citations IA peuvent aussi refléter les limites de l’interface : bases fermées, index partiel, ou recherche web en temps réel activée seulement dans certains modes. Sur des sujets instables, la fraîcheur du contenu devient critique, et Wikipédia / Wikidata peut dominer même quand une source primaire existe. Le bon réflexe consiste à lire le passage cité, pas seulement le titre du site.
Vérifier, recouper et compléter les informations citées
Traitez les citations LLM comme un point de départ. Le risque principal n’est pas seulement l’erreur, mais l’omission : un angle manquant, une définition imprécise, ou une généralisation. Pour limiter ces biais, construisez une petite “matrice de preuves” : une affirmation, puis plusieurs types de validations (source primaire, organisme officiel, données, contre-exemple). Cela vous force à sortir de la simple recommandation autoritaire.
- Ouvrir la source et vérifier que le passage soutient réellement l’affirmation (pas un titre trompeur).
- Contrôler la date, le contexte et la fraîcheur de l’information, surtout en droit, santé, finance.
- Remonter à la source primaire (texte officiel, étude, jeu de données) quand c’est possible.
- Comparer au moins deux sources fiables, idéalement de natures différentes (institution, recherche, média).
- Repérer les zones “sans preuve” : chiffres sans méthodologie, causalités affirmées, définitions floues.
Si l’outil s’appuie sur du RAG, gardez en tête que le modèle ne voit souvent que des extraits. Un passage très “proche” lexicalement peut être sélectionné, même s’il est incomplet. Quand l’enjeu est important, demandez explicitement des liens vers des documents originaux, puis reformulez la question en imposant des contraintes (pays, période, hypothèses) pour tester la robustesse des réponses.
Articuler usages des LLM, SEO classique et branding
Au quotidien, utilisez les LLMs pour accélérer la recherche, pas pour “déporter” la responsabilité : collecte de sources, synthèse, angles à explorer, puis validation humaine. Côté marketing, alignez vos pratiques avec le SEO et une stratégie geo : documentez vos sources, gardez des preuves, et recyclez ces apprentissages dans votre stratégie de contenu SEO. L’automatisation SEO peut aider à détecter des manques (dates, citations, pages orphelines), mais elle ne remplace pas l’expertise.
Questions fréquentes
Comment vérifier si un LLM cite déjà mon site ou ma marque dans ses réponses ?
Vous pouvez tester des requêtes proches de vos contenus et analyser les références affichées, quand l’interface les expose. Variez les formulations et les langues. Surveillez aussi les rapports d’attribution proposés par certains outils d’IA. Enfin, recoupez avec l’analyse de logs et les referers atypiques pour repérer d’éventuels nouveaux chemins d’accès à vos pages.
Pourquoi mon site n’est-il jamais mentionné dans les sources des LLM alors que je suis bien positionné sur Google ?
Un bon SEO ne garantit pas une présence dans les sources des LLM. Les modèles combinent d’autres signaux : fraîcheur, typologie de contenu, diversité éditoriale, contraintes légales, filtres de sécurité. Ils peuvent privilégier des pages pédagogiques ou institutionnelles. Vos contenus peuvent aussi être résumés sans attribution explicite. Il faut donc travailler formats, structure et réputation globale, pas seulement les positions SERP.
Faut-il ajouter des balises ou des formats spécifiques pour que les IA réutilisent mieux mes contenus ?
Les balises structurées, le balisage sémantique clair et un HTML propre facilitent l’extraction d’information, ce qui peut aider les IA. Les formats type FAQ, guides structurés ou tableaux sont souvent mieux réutilisés. En revanche, il n’existe pas encore de balise magique pour garantir l’utilisation de vos pages comme sources LLM. Mieux vaut viser la clarté, la cohérence et la mise à jour régulière.
Les réponses d’IA vont-elles faire disparaître le trafic SEO vers les sites de contenu ?
Les assistants réduisent certains clics informatifs simples, mais ils créent aussi de nouveaux parcours et besoins de validation. Le trafic devrait se requalifier plutôt que disparaître. Les sites qui apportent expertise, données originales, outils ou points de vue différenciants garderont un rôle clé. L’enjeu est d’identifier les requêtes où la visite sur site reste indispensable et d’y concentrer l’effort éditorial.
Comment former une équipe marketing à bien interpréter les sources d’un LLM ?
Commencez par rappeler le fonctionnement des modèles et leurs limites : hallucinations, biais, couverture incomplète. Organisez des ateliers de tests guidés, où chacun apprend à interroger l’IA, à lire les citations et à remonter aux pages sources. Mettez en place un protocole de vérification systématique pour les contenus sensibles. Enfin, documentez les bons réflexes et cas d’usage dans un guide interne simple.